
News Briefing
今日快讯
采集窗口:北京时间 11 月 12 日 08:00 至 11 月 13 日 08:00;RSSHub 暂不可用,本期改用 HuggingNews 与官方来源补齐,并已与 #415 逐条去重。
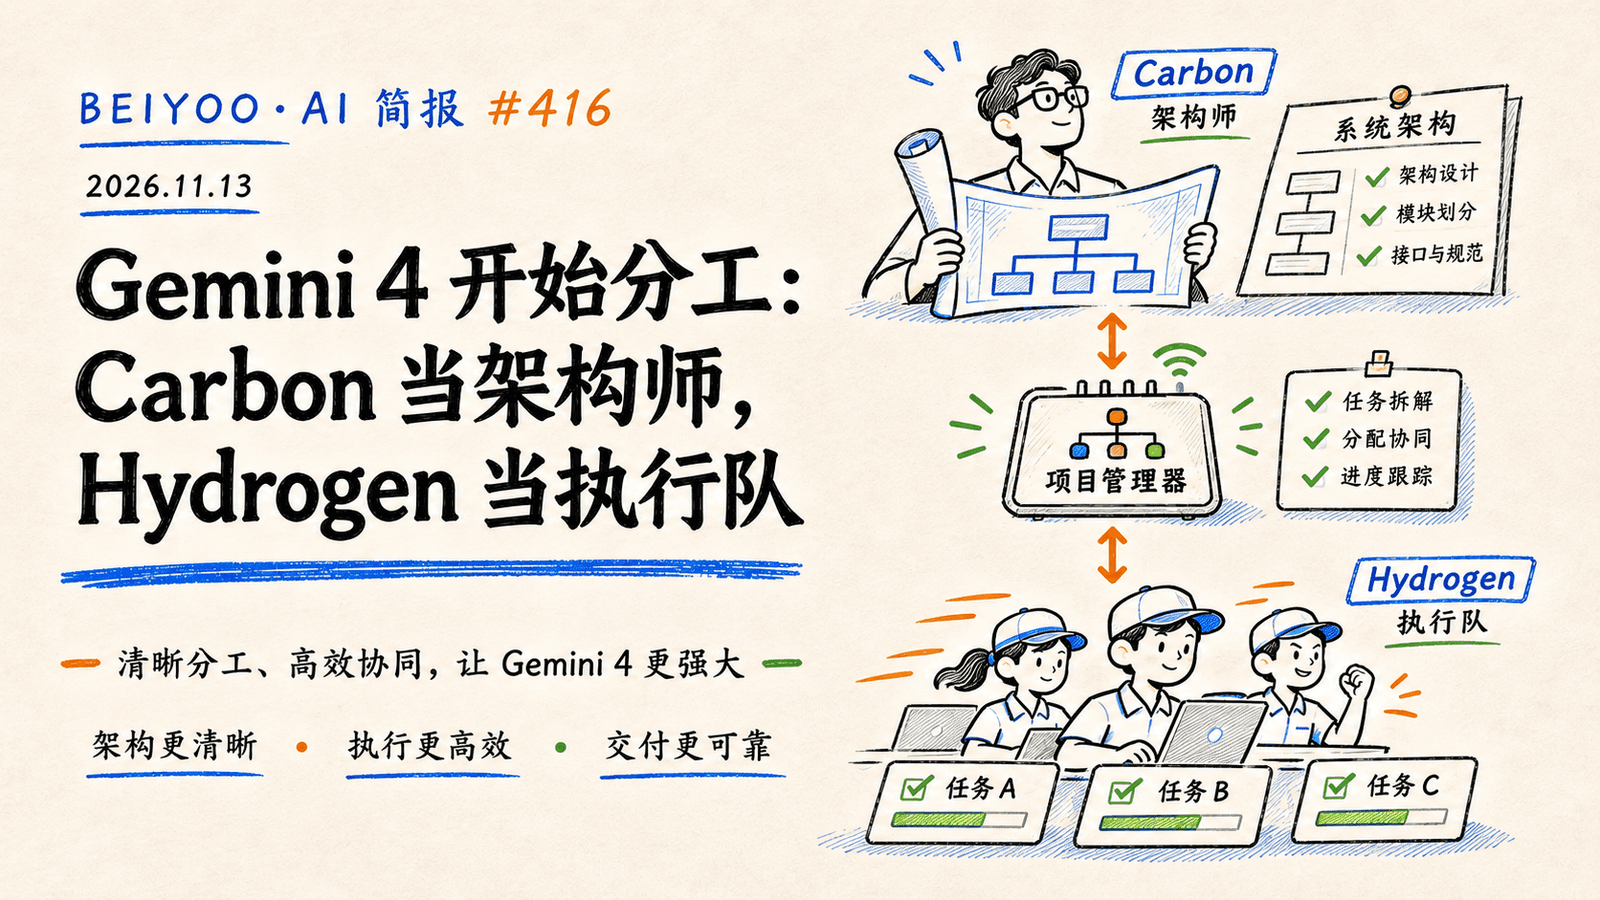
Gemini 4 Hydrogen 让智能体从“一模到底”转向按任务分工
标签:Google / Gemini 4 / 智能体编排
来源:Google 官方发布
摘要: Google 发布 Gemini 4 Hydrogen,并在 Antigravity 中用 Orchestrator 把任务动态交给 Carbon 或 Hydrogen:前者处理高难规划,后者负责文件编辑、命令执行和结果复核。Google 称,在 Terminal-Bench 4.0 的官方测试中,该组合达到接近 Carbon 的成功率,同时平均少用 24% 配额、快 19%;这些数字是特定基准结果,不应外推为所有工作流的固定收益。Hydrogen 支持 1M 上下文,API 定价为每百万输入 Token 1.50 美元、输出 Token 7.50 美元。
Inkling 2 Small 开放权重,17B 激活参数进入主流推理栈
标签:Thinking Machines / 开放权重 / 多模态模型
摘要: Thinking Machines 在 11 月 12 日开放 Inkling 2 Small 权重,并提供 Unsloth、SGLang、vLLM 与 TokenSpeed 等集成。模型总参数 594B、每次激活 17B,支持图像输入和可变推理强度,以 Apache 2.0 许可分发。开放权重使团队能把模型部署到自有推理栈,但真实吞吐、显存、量化损失和长任务稳定性仍需用自有负载复测。
ParseBench-2 用错误严重度重新评测文档解析
标签:LlamaIndex / 文档智能 / OCR
摘要: LlamaIndex 发布 ParseBench-2 与 OCRia-1.5,不再只用一个平均准确率概括表格、公式和阅读顺序,而是按错误类型与业务严重度定位问题。官方结果称,Agentic Plus 模式得分 88.4、每页成本约 0.0281 美元,高于其对比的直接视觉模型 85.0 分;这是厂商测试,重点价值在于让团队知道错在哪里、值不值得修,而不只是比较榜单名次。
Expo 给编码智能体提供真实 iOS 与 Android 云端模拟器
标签:Expo / 移动开发 / 编码智能体
来源:Expo 官方文档
摘要: Expo Simulators 允许 Codex、Claude Code 与 Cursor 等编码智能体申请远程 iOS 或 Android 环境,安装应用、操作界面并返回截图、录像和日志。它相当于给会写代码的智能体配了一部可远程接管的测试手机,让“代码看起来正确”进一步变成“应用真的跑过”。团队仍要管理测试账号、隐私数据、并发成本与失败清理,不能把模拟器证据等同于真机全量验收。
Simular Box 把可共享、可接管的云电脑交给智能体
标签:Simular / 云电脑 / 智能体基础设施
摘要: Simular Box 提供带 Chrome 和终端的持久化 Ubuntu 云电脑,可通过 MCP 连接多个智能体,同一环境能保留登录状态、文件与执行记录。用户可以实时观看或接管操作,密钥也能在不直接暴露给模型的情况下使用。它像一间可观察的共享办公室,但“共享”同时放大了权限串用与状态污染风险,生产环境应继续隔离身份、目录和网络范围。
Perplexity 开放 pplx-decider-v1.3,把路由与抽取做成小模型
标签:Perplexity / 模型路由 / 数据抽取
摘要:
Perplexity 发布开放权重 pplx-decider-v1.3 与 flash 版本,并新增 locate 能力,从原文定位命名实体、PII 或抽取式问答所需的精确片段。模型以 Apache 许可发布,也可通过 Hugging Face、OpenRouter 和 Decisions API 使用。它体现出一个实用方向:不必让通用大模型处理每次路由与字段抽取,小模型可以成为工作流里的低成本门卫。
World Labs 扩大 Atlas 公众访问,世界模型走向可用产品
标签:World Labs / 世界模型 / 3D 生成
来源:World Labs Atlas 官方介绍 · HuggingNews 资讯页
摘要: World Labs 扩大 Atlas 的公众访问,用户可从文本、图像、视频或 3D 输入生成并重建可探索的三维世界,通过网页应用与 API 使用。官方介绍包括最高一分钟、1440p 输出和 3D Gaussian Splat 导出。对创作团队而言,它更像可继续编辑的“空间草稿”而非一张成图,真正进入生产仍要核对几何一致性、资产授权、导出兼容和单位场景成本。
LiquidCodec 用 74M 参数承担流式语音压缩
标签:Liquid AI / 音频模型 / 端侧推理
来源:Liquid AI LFM3 官方介绍 · HuggingNews 资讯页
摘要: Liquid AI 发布约 74M 参数的 LiquidCodec,为 LFM3-Audio-2B 与 Omni-2B 提供流式音频编码和解码,并覆盖 107 种语言。官方在 M4 Max 单 CPU 线程上的测试称,编码可达实时的 361 倍、解码 87 倍;这些是厂商特定硬件测试。小型流式编解码器可降低语音智能体的延迟与带宽,但端侧设备差异、口音和噪声条件仍需单独验证。
SGLang Consortium 汇集芯片、云与模型厂商维护推理栈
标签:SGLang / 开源推理 / 产业联盟
来源:LMSYS 官方发布
摘要: SGLang Consortium 宣布成立,创始成员包括 NVIDIA、AMD、Intel、Google、Meta、Cloudflare、Modal 与 RadixArk。联盟将围绕路线图、跨硬件优化和生态协作开会,同时由项目维护者继续掌握技术决策。它说明推理层正从单一框架竞争走向跨芯片共同维护;企业可因此减少绑定,但仍要关注版本兼容、回归测试和供应链责任。
腾讯内部谈“核心业务与 AI 原生”双线配置,外界误读被澄清
标签:腾讯 / 组织转型 / 中国 AI
摘要: HuggingNews 转述腾讯内部讲话称,管理层用“陆军”比喻核心业务、“海军”比喻 AI 原生方向,讨论如何在两条线之间配置组织资源。外界一度把“50%”解读为裁员或精确的人力转岗比例,腾讯随后否认“裁员 50%”的说法。由于暂无完整官方原文,本期不把该数字写成已执行的人事决定,更值得关注的是中国大厂正在把 AI 原生业务从工具升级提升为组织级资源问题。
Retell 推出 Tell 1,把百万小时真实通话用于语音智能体
标签:Retell / 语音智能体 / 客服自动化
摘要: Retell 发布面向企业语音自动化的 Tell 1,称训练使用超过一百万小时客户通话,并推出 Conductor 分析失败通话、生成测试和修复建议。真实通话数据能帮助模型处理打断、口音和噪声,但也把同意、脱敏、留存与地域合规推到更前面。企业采购时应同时检查通话完成率、错误升级、录音授权和人工接管,而不只听一段流畅演示。
Flash ALOHA 用 50 次示范训练机器人快速完成双臂任务
标签:机器人 / 模仿学习 / 具身智能
摘要: Flash ALOHA 研究展示了用每项任务约 50 次人类示范训练双臂机器人,在部分选定任务中以接近人类速度执行,团队报告成功率超过 80%。这像先让学徒反复看师傅完成一小套动作,再要求它在固定工位独立复现;优势是数据量相对可控,边界是环境变化、物体差异和异常恢复尚未因此解决。相关数字属于项目团队在所选任务上的研究结果,不能直接等同于通用仓储或工厂部署能力。