
News Briefing
今日快讯
采集窗口:北京时间 11 月 2 日 08:00 至 11 月 3 日 08:00;已与 #408 逐条去重,并排除仅因二次传播重新登榜的旧闻。
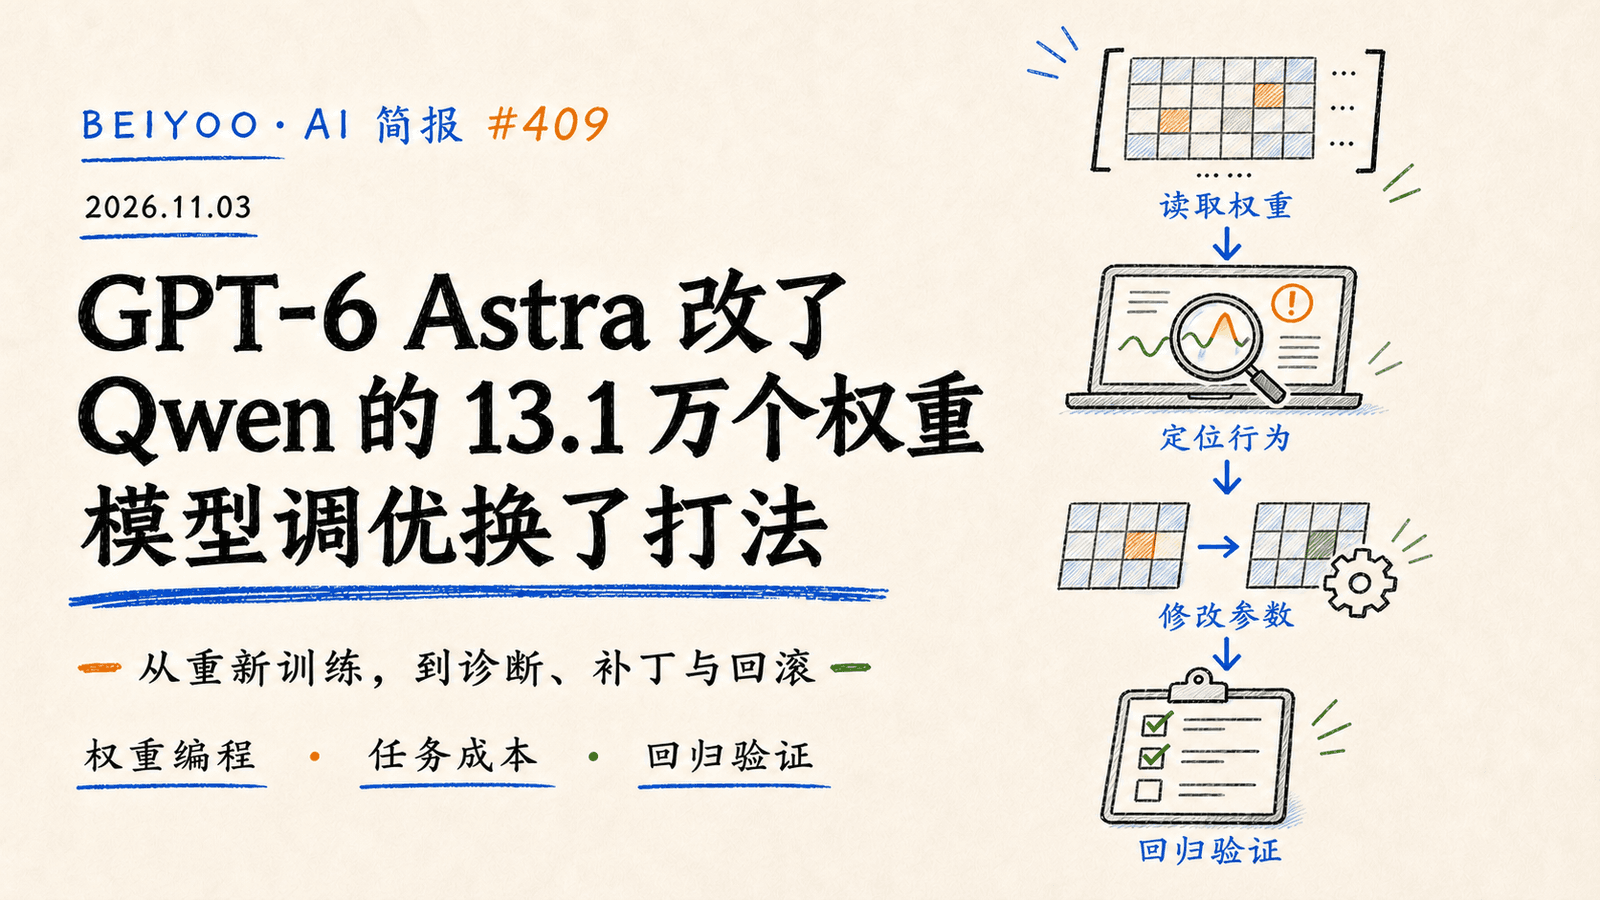
GPT-6 Astra 直接修改 Qwen 权重:数学分数从 7.9% 提至 48.1%
标签:权重空间编程 / MIT CSAIL / 模型工程
摘要: MIT CSAIL 相关研究团队演示了一种“权重空间编程”方法,让 GPT-6 Astra 读取 Qwen3.5-0.8B 的权重和激活,定位重复推理信号,并直接修改两个 MLP 层中的约 13.1 万个权重。事件汇总称,目标模型的 MATH-500 分数由 7.9% 提至 48.1%,过程没有使用传统梯度更新或完整重训,计算预算约为 50 次前向运行。结果很吸引人,但目标模型较小、公开材料仍有限,企业不应把单项基准提升等同于整体能力提升,任何权重补丁都需要更广泛的回归和安全评估。
美团发布 LongCat-2.5:1.6T 多模态模型面向设计与 3D 编程
标签:美团 / LongCat / 多模态模型
来源:LongCat 官方平台更新 · HuggingNews 事件汇总
摘要: 美团发布 LongCat-2.5,模型总参数约 1.6T,每次推理激活约 48B–49B,重点增强视觉理解、长程智能体编程、创意设计和 3D 任务。当前主要通过 LongCat API 提供,官方公开信息尚未确认与 2.0 相同的完整开放权重安排。对企业开发者而言,参数规模本身不是结论,真正需要验证的是多轮任务的稳定性、视觉输入成本、工具调用成功率和项目级上下文保持能力。
Gemini 4 Carbon 在 GDPx 专业智能体基准逼近 Opus,成本约低四倍
标签:Google / 智能体评测 / 成本
来源:Google 官方模型介绍 · GDPx 官方榜单 · HuggingNews 事件汇总
摘要: SemiAnalysis 发布 GDPx 专业智能体基准,覆盖 11 个领域的 206 项长任务。Claude Opus 5.5 以 12% 成功率领先,Gemini 4 Carbon 为 10.9%,但榜单显示 Carbon 平均每任务约 16.29 美元,成本明显低于 Opus。所有模型的绝对成功率仍很低,金融和法律等领域甚至出现严格口径下的零成功,因此企业选型应同时看任务通过率、单次成本和失败后的人工返工,而不是只看综合排名。
Hydrogen-1.0 开放科研模型权重,基于 GLM-5.3 训练
标签:科研智能体 / 开放权重 / GLM
来源:Hugging Face 官方模型页 · HuggingNews 事件汇总
摘要: Deep Principle 发布 Hydrogen-1.0,一款基于 GLM-5.3 后训练的科研问题求解与研究辅助模型,提供 BF16 权重以及面向不同硬件的量化版本,采用 MIT 许可证。团队自报其在 FrontierScience-Research 获得 38.3%,在 GPQA-Diamonds 获得 93.0%,但模型卡也明确要求结合任务假设、证据与专业审查判断输出。科研模型的价值不在于替代研究人员,而在于能否接入计算、实验记录和文献工具,并保留可复核的推导链。
Anthropic 称未来模型可能把 AI 研发速度推高一倍
标签:Anthropic / 研发自动化 / 模型治理
来源:Anthropic SEC 修订文件 · HuggingNews 事件汇总
摘要: Anthropic 在 11 月 2 日提交的 S-1/A 文件中强化了对 AI 加速研发风险的描述,内部估计认为未来模型可能触发“由 AI 导致的显著加速进展”阈值,即能力进步速度达到基线预期的两倍。公司同时表示,当前模型尚未达到完全自主设计下一代前沿模型的程度,并考虑在关键研发决策中保留人工审核。对企业而言,这类披露的启示不是追逐递归自我改进叙事,而是提前规定哪些模型变更必须由人理解、批准和承担责任。
OpenAI 称下一代 GPT 将沿用 Navier–Stokes 研究模型路线
标签:OpenAI / 科学推理 / 多智能体
摘要: Sam Altman 表示,OpenAI 用于 Navier–Stokes 方程研究的内部模型将成为下一代 GPT 的技术基础,相关任务据称由约一万个智能体连续协作四天完成。模型尚未正式发布,外部也无法据此评估所谓数学突破的完整证明、验证过程和可复现性。企业可以关注大规模多智能体协作的任务编排方式,但不应把高并发代理数量直接当作结果可信度,验证责任仍然独立存在。
OpenAI 推出 Grid Protectors:高峰期最多释放 1GW 负荷
标签:OpenAI / 数据中心 / 能源
来源:OpenAI 官方发布 · HuggingNews 事件汇总
摘要: OpenAI 发布 Grid Protectors 计划,承诺未来计算园区在电网紧张时降低用电,并承担自身电力与配套基础设施成本。首个落地项目位于美国佐治亚州 Effingham County,协议包含最高 1,000MW 的可调需求响应,相当于约 70 万户家庭的平均用电。AI 基础设施竞争正把模型调度延伸到电力调度,企业核算推理成本时也需要把峰谷电价、容量约束和可中断任务纳入架构设计。
OpenAI 与阿布扎比签约,把 Frontier 带进能源和投资工作流
标签:OpenAI / 企业智能体 / 阿联酋
来源:Inception42 官方公告 · HuggingNews 事件汇总
摘要: OpenAI、Inception42、ADNOC 与 Mubadala 宣布多项合作,把模型和智能体能力用于油气生产、交易决策、投资分析、风险评估与企业服务。协议还涉及把监管文本转成机器可读格式,以支持自动化合规检查。大型企业采用 AI 的重心已经从购买聊天席位转向重构决策链,但能源、金融和监管场景必须保留数据驻留、证据来源、权限分层和人工复核。
Humansand 开源“权重传送”,把强化学习采样暂停压到 0.23 秒内
标签:强化学习 / 分布式训练 / 开源基础设施
摘要: Humansand 公布并开源一套名为 weight teleportation 的权重更新方法,通过 GPU 并行压缩和非阻塞准备,将强化学习采样器因权重同步产生的暂停时间压到 0.23 秒以内。团队称约 3 秒即可完成压缩与准备,从而让训练集群和采样集群跨数据中心协作。公开数据主要来自开发者自报,实际收益仍取决于模型规模、网络带宽、硬件解压能力和容错设计,但它指向一个明确趋势:训练基础设施正从单一机房优化走向跨集群编排。
Meta TextSeal2:在特定测试中识别 89% 的生成文本
标签:Meta / 文本水印 / 内容治理
来源:TextSeal2 论文 · HuggingNews 事件汇总
摘要: Meta 研究者提出 TextSeal2,通过 copula mixing 和无记忆竞速机制为生成文本嵌入隐蔽信号,目标是在不增加解码延迟、不压缩输出多样性的情况下支持来源检测。论文在 Qwen3.5-9B 的特定设置中报告:对 200 Token 文本,在 0.1% 误报率下检测率达到 89%。这仍不等于通用的“AI 文本鉴定器”,企业应把水印视为来源证据的一层,并与生成日志、模型版本和内容审批共同使用。
Goldman Sachs 限制非工程岗位使用 Claude Code 和 GitHub AI 工具
标签:金融业 / 编码智能体 / 权限治理
摘要: Goldman Sachs 被报道将 Claude Code 与 GitHub AI 工具的使用范围收缩到工程岗位,交易与投行业务人员不再获准直接使用这类编码助手。公开信息没有披露具体事件或损失,限制理由主要指向风险与生产率管理。这个案例提醒企业,按工具名称“一刀切”并不理想,更可持续的做法是按岗位、数据敏感度、可执行动作和审计能力配置权限。
DeepSeek Harness 释出 Creator Mode 的七个插件生成示例
标签:DeepSeek / 插件生态 / 自定义工具
来源:DeepSeek Harness 官方 GitHub · HuggingNews 事件汇总
摘要: DeepSeek Harness 发布 Creator Mode 的演示视频和七组提示词,展示用户如何用自然语言描述计时器、设计工作区、视频面板或 3D 可视化工具,再由智能体编写、安装和测试插件。Creator Mode 本身在 8 月已经存在,本次更新的价值在于公开可复用示例,而不是全新功能发布。插件生成降低了定制门槛,也让恶意依赖、权限滥用和不可维护代码更容易进入运行环境,安装前仍需代码审查和最小权限。