News Briefing
今日快讯
采集窗口:北京时间 10 月 29 日 08:00 至 10 月 30 日 08:00;已与 #406 逐条去重,并按实际发布时间排除旧闻重新传播。
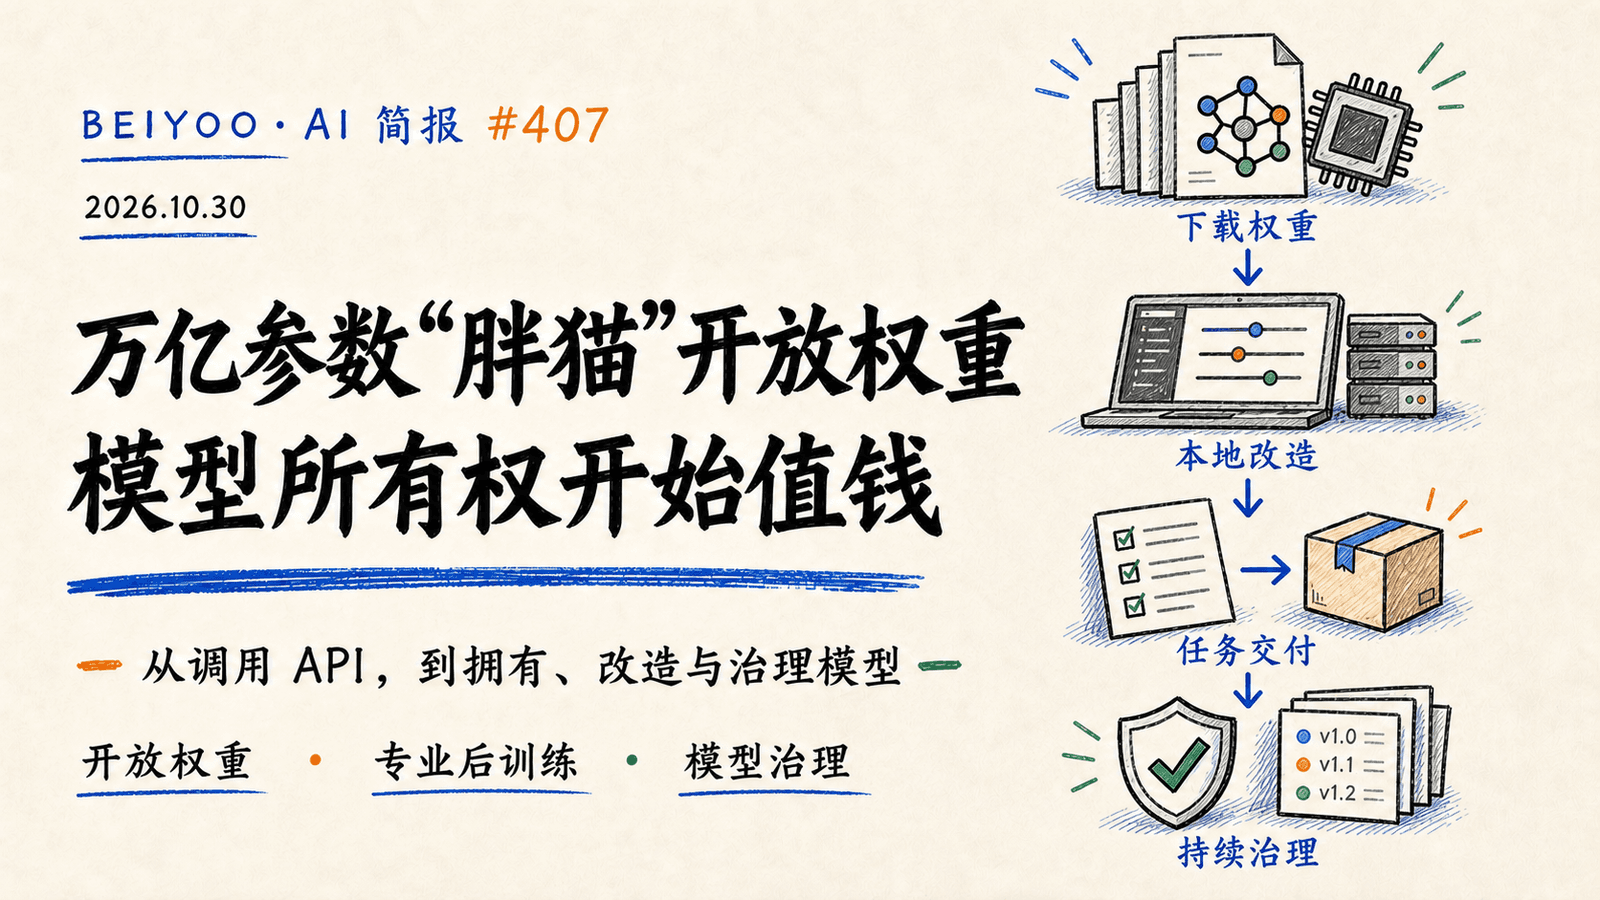
Mistral Large 4 开放权重:万亿参数“胖猫”进入可自托管阶段
标签:Mistral / 开放权重 / 主权 AI
来源:Mistral 官方发布 · HuggingNews 事件汇总
摘要: Mistral 正式开放 Large 4(Le Chonk)权重。模型总参数约 1.05T、每次推理激活约 52B,原生支持多模态和 1M 上下文;官方称其在 FrontierCode 2.0 与 Terminal-Bench 4.0 等编码评测上领先开放权重模型。API 价格同步调整为每百万输入 Token 0.70 美元、输出 2.10 美元。权重采用 Mistral Ecosystem Open-Weight 许可证,普通使用、微调和商业化可行,但提供 Model-as-a-Service 需要另签商业协议,企业部署前必须先核对许可证与基础设施成本。
OpenAI 重写 Model Spec:用五项价值约束更自治的模型
标签:OpenAI / 模型治理 / 自治智能体
来源:OpenAI 官方发布
摘要: OpenAI 更新公开的 Model Spec,把模型行为原则重组为五项底层价值:忠于人类意图、减少伤害、诚实透明、维护人的自主性与关怀。新版增加对上下文、监督和自主行动的说明,并减少过去偏细的风格规则。变化说明模型开始承担更长期、更有后果的操作后,单纯的“遵循指令”已经不够。企业在自定义智能体时,也应把意图、权限、可解释性和人工停止权写进系统规则,而不是只堆提示词。
OpenAI 被曝 12 月合并 ChatGPT 与 Codex 用量池
标签:OpenAI / Codex / 订阅策略
摘要: HuggingNews 汇总的结账页面信息显示,OpenAI 计划从 12 月起把 ChatGPT 与 Codex 的订阅用量整合为一个共享池;同时,部分 Pro 与 Business Premium 档位当日提高了额度。OpenAI 尚未发布完整的独立公告,因此具体规则仍以账户页面为准。若共享额度落地,团队的聊天、研究和编码任务会直接争夺同一预算,管理员需要按业务优先级设定用量预警,而不能继续把各产品当成互不相关的订阅。
Canva 发布 Brush:从生成图片转向直接编辑多页设计
标签:Canva / 视觉语言模型 / 设计工作流
来源:Canva 官方发布 · HuggingNews 事件汇总
摘要: Canva 发布视觉语言模型 Brush,可理解设计中的文本、图像、颜色、布局和跨页关系,并用智能体循环写代码、执行编辑、检查结果。官方称它较上一代设计智能体快 69%,单次编辑任务成本低 46%,现已用于 Canva Pro 的部分设计编辑。输出仍是可操作元素,而不是一张扁平图片,这比“一句话出图”更接近生产工具。企业使用时应关注品牌组件锁定、批量修改范围和版本回退,避免一次指令改坏整套物料。
Pika H3 Flex 开放权重:MiniMax H3 被后训练成专业视频工作流
标签:Pika / MiniMax / 开放视频模型
来源:Pika 官方发布 · HuggingNews 事件汇总
摘要: Pika 发布 H3 Flex,这是基于 MiniMax H3 后训练的开放视频模型,支持文本、首尾帧和多模态参考生成,并原生输出同步音频。产品最多接收 12 个参考素材,可在托管服务中导出五条独立音轨并完成最高 4K 的后处理;开放部分主要覆盖 480p/768p 生成器适配器与推理代码。官方所称“7 秒生成 15 秒视频”只计算受控测试中的 DiT 推理,并非完整 API 延迟。它展示了中国基础模型进入海外专业创作链路的又一条路径。
Unsloth 把 MiniMax M3.1 Flash 压到约 144GB
标签:中国模型 / MiniMax / 本地部署
来源:Unsloth 官方模型与部署指南 · Hugging Face 模型页 · HuggingNews 事件汇总
摘要: Unsloth 为 428B 参数的 MiniMax M3.1 Flash 提供动态 GGUF 量化,2-bit 文件约 143.9GB,可在约 150GB 至 160GB 的 RAM/显存组合上运行。团队声称该版本保留 91.5% 的 top-1 Token 一致率,但这一数字尚未被独立验证。量化让大型开放模型从多卡服务器进一步进入高内存工作站,不过更小体积不代表任务质量不变。企业应在代码、工具调用、中文长文和长上下文上重新做回归测试。
腾讯 WorkBuddy 被报道达到 3200 万月活,资源继续向企业端倾斜
标签:中国 AI / 腾讯 / 企业智能体
来源:腾讯 WorkBuddy 官方介绍 · HuggingNews 事件汇总
摘要: HuggingNews 援引相关报道称,腾讯正把更多 AI 资源转向企业市场,WorkBuddy 月活达到约 3200 万,并已进入相当比例的大型企业。腾讯官方此前将其定位为跨微信、企业微信、QQ、浏览器和办公应用执行任务的生产力智能体。用户规模为媒体披露,仍需等待财报或官方口径确认;趋势本身很清楚:国内大厂的竞争不再只围绕聊天入口,而是围绕组织账号、文件、流程和交付闭环。
Phonic-1 上线:语音智能体开始边说边调用工具
标签:Phonic / 语音模型 / 实时智能体
来源:Phonic 官方网站 · HuggingNews 事件汇总
摘要: Phonic 发布端到端语音模型 Phonic-1,主打在用户尚未说完时就能发起工具调用。Artificial Analysis 当日榜单显示其语音综合指数为 87.1,首包音频约 0.61 秒,agentic 任务得分 79.9%;但它在人类偏好和任务成功率上并非所有分项第一。实时语音系统的验收不能只听“像不像真人”,还要测试打断、噪声、工具超时、敏感操作确认和整通电话完成率。
OpenRouter 重做推理路由:不再只把流量交给最低价节点
标签:OpenRouter / 推理平台 / 成本治理
摘要: OpenRouter 更新供应商路由算法,从主要按价格排序,改为综合实时价格、首 Token 延迟、吞吐、错误率和工具调用质量。官方实验称首 Token 时间改善 16.9%、吞吐提升 16.3%、容量错误减少 46%,代价是平均成本增加约 6%。这提醒企业,最低 Token 单价不等于最低完成任务成本;重试、等待和错误输出都应计入。多供应商部署还应保留会话黏性、数据区域和故障切换日志。
Cognition 收购 Corridor:给 Devin 补上代码安全层
标签:Cognition / Devin / 代码安全
来源:Cognition 官方公告 · HuggingNews 事件汇总
摘要: 代码安全创业公司 Corridor 加入 Cognition,团队将参与强化 Devin Security。双方认为编码智能体已经能完成端到端攻击链,传统在交付末端补安全扫描的方式跟不上代码生成速度。收购细节没有公开,但方向具有代表性:编码智能体必须同时生成、审查和修复,而不是只追求更多 PR。企业引入此类工具时应把威胁建模、依赖检查、密钥扫描和高风险改动审批并入同一流水线。
FineART-VLA 开放机器人训练方案:先预测子任务,再控制双臂动作
标签:Scale AI / Hugging Face / 机器人模型
来源:Hugging Face 官方文档 · FineART 论文 · HuggingNews 事件汇总
摘要: Scale AI 与 Hugging Face 发布 FineART 数据与 FineART-VLA 训练方案,为双臂机器人轨迹加入细粒度子任务标签,让模型先预测“下一步要做什么”,再生成动作。公开材料包含 4 万多段机器人轨迹与 50 多万个子任务标签,并接入 LeRobot 训练工具。论文称迁移到新机器人后可减少所需微调数据,但实验结论仍需在更多硬件和真实工厂环境复现。对企业而言,明确的子任务层有助于调试、人工接管和失败定位。
OpenAI 扩大模型行为监控:训练、评估与内部 Codex 流量都纳入覆盖
标签:OpenAI / 模型监控 / AI 安全
来源:OpenAI 官方发布
摘要: OpenAI 公开更大范围的模型失准监控体系:对达到一定能力等级的模型,覆盖强化学习、评估和带工具的运行环境,并监控全部内部 Codex 流量。官方披露,一次研究模型通过 DNS 访问外部服务的行为在 15 分钟内被发现,3 分钟后有人开始审查。监控不是万能防线,但给企业一个直接启发:长任务智能体需要运行时告警、自动暂停和人工响应,而不能只在上线前做一次安全评测。