News Briefing
今日快讯
采集窗口:北京时间 10 月 27 日 08:00 至 10 月 28 日 08:00;已与上一期逐条去重。
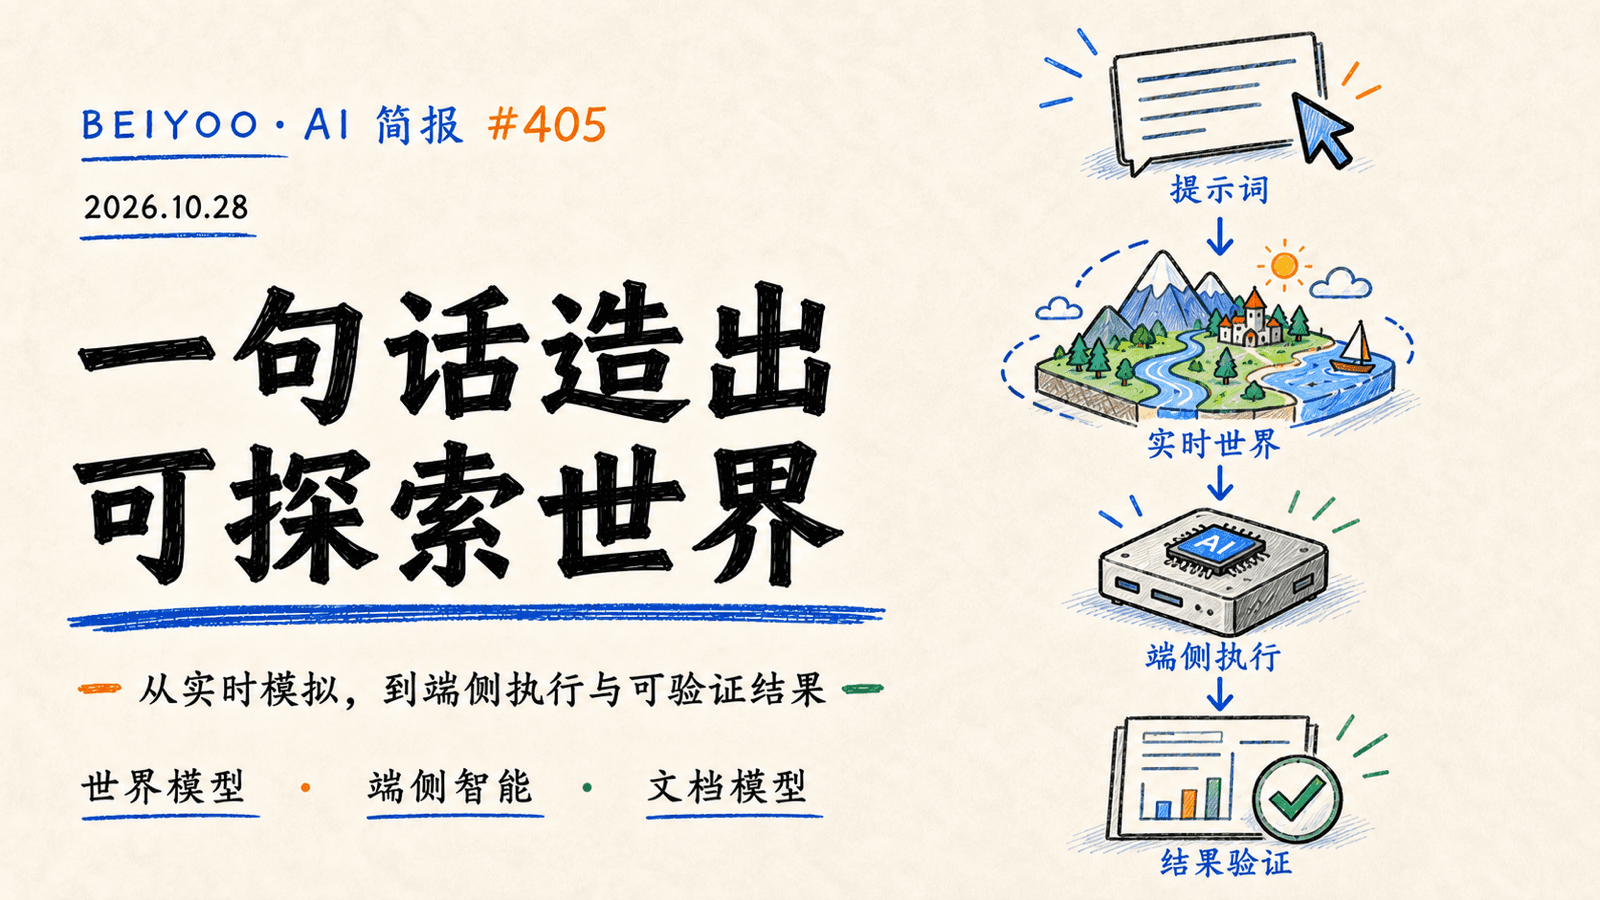
Genie 4 发布:一句提示词生成可探索、可操控的实时世界
标签:Google DeepMind / 世界模型 / 机器人模拟
来源:Google DeepMind 官方发布 · HuggingNews 事件汇总
摘要: Google DeepMind 发布 Genie 4 世界模型,可从单条提示生成带画面、环境音、对话与物理反馈的实时交互空间。用户能在运行中用自然语言改变天气、摄像机、人物和物体,Gemini 模型则负责规划多步事件与维持场景连续性。Genie 4 正以研究预览向可信测试者开放,后续将进入 Project Genie、Gemini API 和 Google AI Studio 的早期访问。对企业更重要的不是“生成一段更真实的视频”,而是能否用可控模拟批量训练机器人、验证智能体和预演复杂场景。
Liquid AI 发布 LFM3:六款 2B 级模型把多模态智能压进端侧设备
标签:Liquid AI / 端侧模型 / 开放权重
来源:Liquid AI 官方发布 · HuggingNews 事件汇总
摘要: Liquid AI 发布 LFM3 系列,首批覆盖文本、视觉、音频、全模态和决策共六个约 2B 参数的模型,基于新的三混合架构与 22T Token 预训练。LFM3-1.7B 提供 256K 上下文,4-bit 量化约占 1GB 内存,并可在单张 GPU 上微调;模型权重已在 Hugging Face 开放。官方同时针对手机、树莓派、CPU、GPU 与 NPU 等 14 类硬件做了优化。端侧模型不再只意味着“牺牲能力换隐私”,企业可以开始为现场设备、离线助手和高频后台代理重新计算云端与本地的总成本。
百度开源 Unlimited OCR 2:整本书可在单次请求中持续解析
标签:中国模型 / 百度 / 文档智能
来源:百度 Unlimited OCR 官方仓库 · HuggingNews 事件汇总
摘要: 百度开源 Unlimited OCR 2,目标是在有限上下文窗口内持续解析近乎任意长度的文档。其 SR-SWA 机制把文本与视觉注意力交互压缩成固定规模的工作引用,使文档页数增长时,单步解码延迟和内存占用保持相对稳定。项目同步发布 MarathonDocBench,并推荐通过 SGLang 部署。对合同、档案和书籍处理而言,真正的价值是减少分页切割、跨页上下文丢失和峰值显存,而不是把“单次请求”误解为完全没有长度或质量边界。
蚂蚁开源 Ling-3.1-flash-1019:560B 总参数、25B 激活参数
标签:中国模型 / 蚂蚁集团 / 开放权重
来源:Ling-3.1-flash-1019 官方模型卡 · HuggingNews 事件汇总
摘要: 蚂蚁集团 InclusionAI 开放 Ling-3.1-flash-1019 权重,模型总参数 560B、每 Token 激活约 25B,并提供 1M 上下文。官方模型卡称其在 Artificial Analysis Intelligence Index v4.3.2 得分从前版的 41 提升至 44,同时发布可供外部继续训练的 Ling-3.1-flash-base。开放权重让企业获得更大的微调、部署和审计自由,但 560B 总参数仍意味着推理并非“轻量”,采用前应验证并行策略、显存占用、长上下文成本和具体中文任务表现。
OpenBMB 发布 MiniCPM-OCR 组合:识别模型之外,再放一个校验模型
标签:中国模型 / OpenBMB / OCR
来源:MiniCPM-OCR 1.0 官方模型卡 · MiniCPM-OCR Jev 官方模型卡 · HuggingNews 事件汇总
摘要: OpenBMB 发布 MiniCPM-OCR 1.0 与 MiniCPM-OCR Jev:前者是约 1.3B 参数的文档识别与版面解析模型,后者用约 2B 参数对原图与候选解析结果进行质量判断。模型面向中英文文本、表格、公式、图表和印章等复杂文档,并提供开放权重。把“识别”和“检查识别结果”拆开,比单纯追逐一次性 OCR 分数更接近生产系统;企业仍应增加字段规则、交叉校验与人工抽样,避免两个模型共享同类盲区。
微软 MAI Image 2.7 预览:图像编辑榜升至第二
标签:Microsoft AI / 图像模型 / 内容生产
来源:Microsoft AI 官方发布 · HuggingNews 事件汇总
摘要: Microsoft AI 发布 MAI-Image-2.7 预览版,在 Artificial Analysis 图像编辑榜位列第二、Arena Edit 位列第三。官方称新模型在十类使用场景和七类编辑动作上全面超过 2.6,尤其提升了场景与风格转换、文字和符号编辑、推理式修改与修复增强。当前可在 MAI Playground、Arena 和 Artificial Analysis 体验,文本生成图像能力将后续加入。排行榜可以帮助筛选候选模型,但品牌素材采购应另测身份保持、中文文字、局部修改稳定性和批量一致性。
Axiom 把有限单群分类写成 4310 万行 Lean 代码
标签:AI for Science / 形式化验证 / 数学
来源:Axiom 官方证明地图与论文 · HuggingNews 事件汇总
摘要: Axiom 公布有限单群分类的 Lean 形式化工程,官网列出 4310 万行 Lean、205 万个声明、715 篇论文和书籍,并开放交互式证明图与代码仓库。该人类证明跨越数十年、由约百名数学家完成,Axiom 称其智能体在人工指导下用 24 天完成形式化,并发现一处已发表论证中的问题、给出替代路径。Lean 内核能检查代码中的每个逻辑步骤,但项目规模、依赖和数学意义仍需要外部学者复核。AI 科研最可信的交付方式,正在从“给出结论”转向“给出可重建、可审查的形式化资产”。
Cognition 推出 FrontierCode 2.0:顶级编码模型仍低于 50%
标签:Cognition / 编码智能体 / 模型评测
摘要: Cognition 发布 FrontierCode 2.0,用需求不完整、工程取舍复杂的真实开源任务评估编码智能体,并把代码是否可合并而非仅能通过基础测试作为核心标准。Claude Opus 5.5 通过率为 45.5%,GPT-6 Astra 为 42.8%;官方还披露,部分任务中提高推理强度反而导致模型做出过度修改。每道题由开源维护者投入 40 小时以上制作,初稿有 80% 被退回重做。企业应把模糊需求处理、清理工作、公共 API 兼容和评审成本纳入编码智能体评估,而不是只看补丁能否运行。
Ramp 开放 Inspect:内部 74% 合并 PR 已来自编码智能体
标签:Ramp / 编码智能体 / 企业应用
来源:Ramp 官方发布 · HuggingNews 事件汇总
摘要: Ramp 开放协作式编码智能体 Inspect 的早期访问,用户可从 Slack、GitHub、Linear 或网页发起任务,系统在云端环境完成修改、视觉验证和代码审查后生成 PR。Ramp 称过去一个月 99% 的工程、设计和产品团队使用过 Inspect,74% 的合并 PR 来自该工具,人均提交量较一年前提升 3.4 倍。这是厂商自报的内部数据,不能直接外推到其他团队;它仍说明智能体大规模落地依赖共享上下文、可加入的多人会话和可验证产物,而不只是更强模型。
LangChain 开源 Content Studio:在 Slack 里生成视频、图像和演示文稿
标签:LangChain / 内容智能体 / 开源
来源:LangChain 官方发布 · HuggingNews 事件汇总
摘要: LangChain 开源内部设计智能体 Content Studio,可在 Slack 线程中协同生成品牌视频、图像、演示文稿和 UI 稿,并把输出写成可编辑代码。官方称该系统已在公司内部交付 3000 多份素材和 80 多套演示文稿,单次请求模型成本中位数从约 8 美元降至 0.5 美元。它的关键不是“一句话出图”,而是把设计判断写进技能与检查,把沙箱、记忆、异步子任务和协作界面组成长任务工作流。企业复用时需要把品牌规范、审批与素材版权一并编码进流程。
Sentient OS 让本地模型整夜整理个人上下文
标签:本地智能体 / 隐私 / 端侧推理
摘要: YC F26 创业公司 Sentient 发布 Sentient OS,让本地大模型在设备上持续读取和整理数字上下文,并在夜间运行长期任务。系统把获取的上下文保存为用户拥有的 Markdown 文件,强调离线运行、无限本地推理和较低云端成本。其主动式体验仍需验证资源占用、权限解释和数据删除是否可靠;对企业而言,这类架构适合探索个人知识整理和离线场景,但必须按最小权限限制可读目录,并提供清晰的暂停、清除与审计机制。
Google 提出“睡眠”框架,让大模型持续学习又减少灾难性遗忘
标签:Google Research / 持续学习 / 模型研究
来源:Google Research 官方发布 · HuggingNews 事件汇总
摘要: Google Research 提出大模型持续学习的“睡眠”框架,让模型在活跃阶段接收新信息,在离线阶段完成记忆巩固和“做梦”式自我训练。框架通过扩展 MoE 记忆模块、知识蒸馏、强化学习和合成数据,把短期上下文转入更稳定的长期参数,并在实验中保持最高 1000 万 Token 的长期知识。研究仍属于训练方法探索,不代表线上模型会自行无限更新。对企业知识系统的启发是,把实时记忆、周期性固化、回归测试和可撤销版本分开,比持续在线微调更可控。