News Briefing
今日快讯
今日快讯
采集窗口:北京时间 10 月 20 日 08:00 至 10 月 21 日 08:00;已与上一期逐条去重。
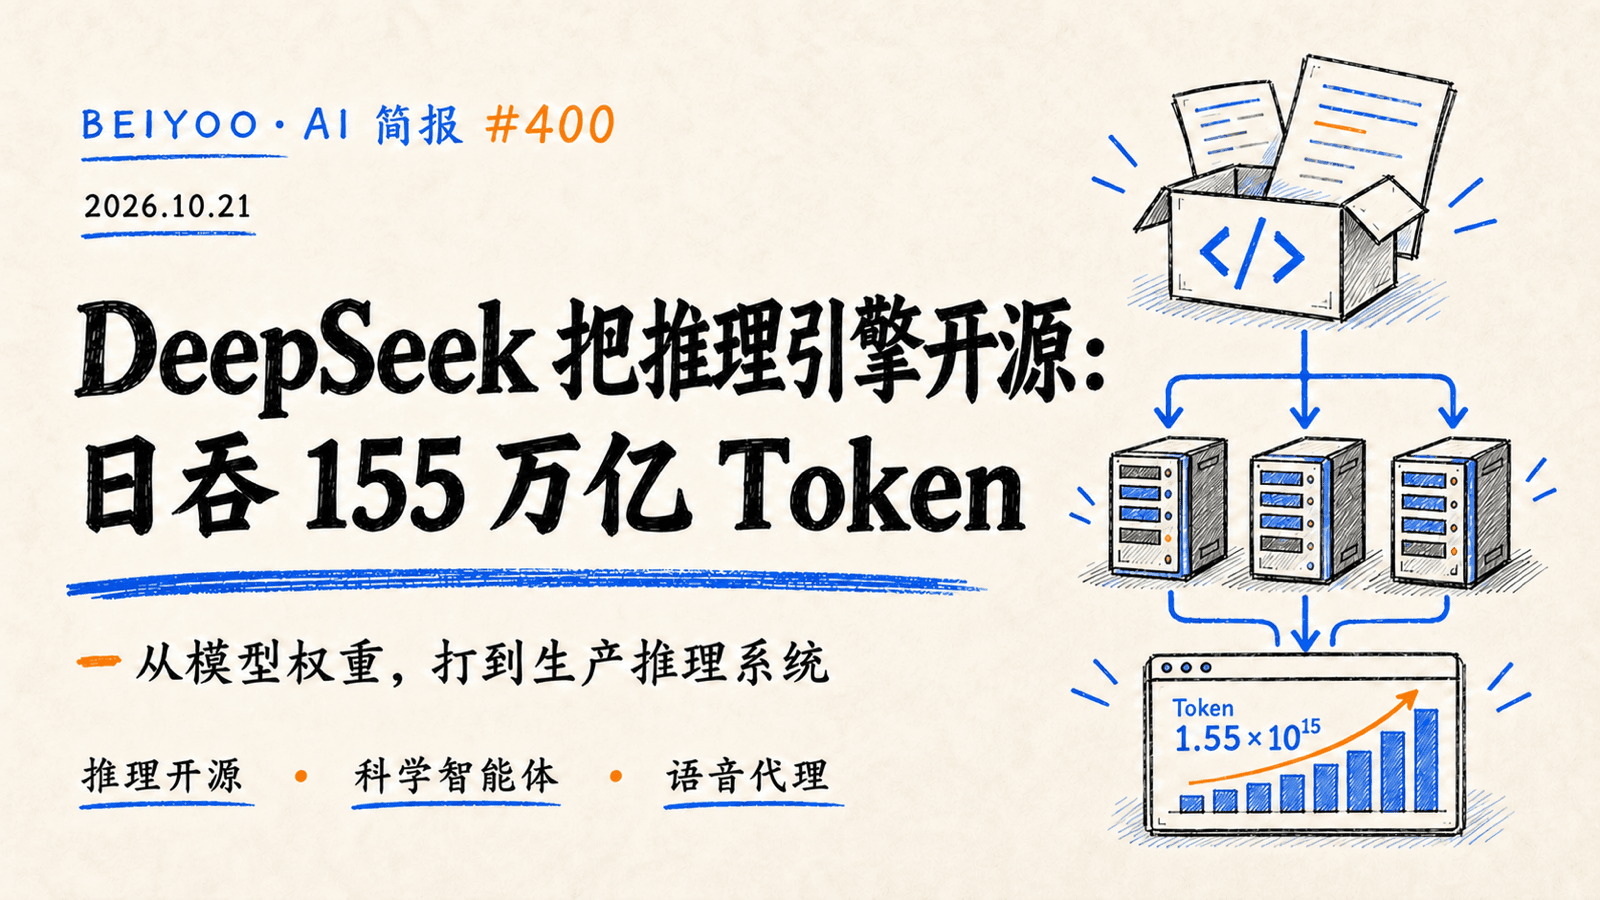
1. DeepSeek 把生产推理“发动机”开源:单集群每日处理 155 万亿 Token【中国】
标签:DeepSeek / 推理框架 / 开源基础设施
摘要:DeepSeek 开源内部生产级推理框架 DeepInfer,以及负责多种 API 协议与模型 Token 序列转换的 deepseek-recipe。官方披露,支撑 DeepSeek V4.1 Flash 的单集群每日处理 155 万亿 Token;框架集成优化内核、注意力与专家并行、推测解码、SWA bounded replay、结构化输出和异步调度,并同时支持 NVIDIA 与华为昇腾平台。需要注意,当前开源版本主要提供离线推理能力,KV 缓存管理、预填充与解码分离、负载均衡等与内部设施深度耦合的组件尚未完整公开,因此它更像生产技术路线的开放起点,而非开箱即用的完整云服务。
来源:DeepInfer 官方仓库 · DeepSeek 推理部署问答 · deepseek-recipe 官方仓库
2. Claude 两天设计 31.8 万个候选,17 个蝎毒蛋白结合体通过实验验证
标签:Anthropic / AI for Science / 蛋白设计
摘要:Anthropic 与 Citrini Research 让内部研究模型在 Claude Science 中运行 64 小时,生成 318,484 个蛋白设计,并筛出 180 个候选;研究团队随后补充 31 个,共交由 Adaptyv Bio 与 Twist Bioscience 两家实验室验证。最终 17 个设计满足结合标准,覆盖四种对人危险的蝎毒靶点。Anthropic 明确说明,这些分子尚未证明能在细胞环境中中和毒素,也没有形成抗毒药物;但从自主设计、筛选到外部湿实验验证的闭环,展示了科学智能体可以承担比单次预测更长的研究流程。
3. OpenAI 收购 Orchestra Bio,把 Rosalind 从科研问答推进到药物研发协作
标签:OpenAI / 生物医药 / 智能体
摘要:OpenAI 收购药物研发协作平台 Orchestra Bio,并计划把其团队与技术并入生命科学产品 Rosalind。Orchestra 的智能体用于监控跨部门与外部合作方的研究任务、识别一处延误对其他环节的连锁影响,并帮助团队比较应对方案;与 GPT-Rosalind 和 Rosalind Workbench 结合后,OpenAI 希望覆盖从科学推理、实验规划到项目推进的更长链路。收购价格未披露,这次交易的关键也不是模型跑分,而是把智能体嵌入平均需要 10 至 15 年的药物研发运营流程。
来源:OpenAI 官方公告
4. Mistral 发布 Voxtral 3,语音智能体开始按“听、想、做、说”整套交付
标签:Mistral / 语音模型 / 智能体 SDK
摘要:Mistral 发布 Voxtral 3 系列与语音智能体 SDK,把转写、推理、工具调用和语音合成串成实时流式管线。Voxtral Small Transcribe 3 覆盖 50 多种语言,实时版支持端点检测;Voxtral Speech 3 覆盖 35 多种语言和 50 多种方言,能根据上下文调整情绪、速度与重音。官方称完整链路可在每轮对话中做到一秒以内响应,并提供欧盟托管 API 与私有化部署选项;真实客服场景仍需重点复测打断处理、专有名词和工具失败后的恢复能力。
来源:Mistral 官方发布 · Voxtral Small Transcribe 3 文档
5. Google 与 Inferact 开源 TorchTPU,标准 PyTorch 模型更容易搬上 TPU
标签:Google / TPU / PyTorch
摘要:Google 与 Inferact 团队开源 vLLM TorchTPU,它以 vLLM 平台插件的方式,让标准 PyTorch 模型定义通过 TorchTPU 编译后运行在 Google Cloud TPU。项目包含针对注意力、MoE 和量化矩阵乘法的 JAX/Pallas 内核,并支持多主机并行、KV 缓存卸载和预填充—解码分离。当前 TPU v6e、v5e 与 v5p 仍被标为实验性支持,尚未纳入持续集成测试;但它减少了开发者为换硬件重写模型代码的工作,也让 TPU 更直接进入开放推理框架的竞争。
6. Omnii-1 设计的噬菌体进入单个患者治疗,但临床效果仍未披露
标签:生物基础模型 / 生成式基因组学 / 医疗边界
摘要:Radical Numerics 发布多模态基因组模型 Omnii-1,并称模型针对一名耐药性大肠杆菌感染患者的细菌样本设计了噬菌体,在实验室杀菌测试和安全流程后,经授权用于该患者。公司将其称为首个进入人体使用的 AI 设计噬菌体案例,但没有披露患者是否改善、是否清除感染或是否出现不良反应,相关技术报告也尚未经过同行评审。因此这是一项从计算设计走向临床使用的阶段性事件,不能被表述为已经证明安全有效的“AI 治愈”。
来源:Radical Numerics 官方研究页 · HuggingNews 事件汇总
7. Mastercard 开放机器支付测试:智能体可在预算内购买模型、数据与算力
标签:智能体支付 / Mastercard / 权限治理
摘要:Mastercard 为 Agent Pay for Machines 开放早期访问,让开发者测试智能体购买数字服务的机器间支付流程。企业先给任务、预算和权限;当服务返回 402 Payment Required 时,智能体生成有签名的支付凭证,商家验证后交付服务,凭证可稍后汇总清算。试点连接了 Cloudflare、Coinbase、Base、Ant International 等伙伴,强调的不是给智能体无限钱包,而是把身份、用途、额度和收款方约束写进交易链路。
8. Bria Fibo 2.0 冲上开放权重图像编辑前列,但商用仍需单独许可
标签:图像模型 / 开放权重 / 商用许可
摘要:Bria 发布 80 亿参数的 Fibo 2.0,提供偏速度的 Turbo 版和面向微调的 Dev 版,并获得 Diffusers 与 fal 的上线支持。官方与第三方榜单显示,它在开放权重图像编辑与文生图评测中进入前列;API 标价为每 1,000 张 32 美元。模型权重虽然可下载,但采用非商业许可证,企业若要用于商业产品仍需另行签约,这再次提醒团队不要把“开放权重”直接等同于“可自由商用”。
来源:Bria 官方更新 · HuggingNews 事件汇总
9. Ornith 推出 122B 开放权重模型,把大型编码模型压进单台 DGX
标签:开放模型 / 编码智能体 / 本地部署
摘要:Ornith 发布 Ornith-1.5-122B,并提供 FP8、NVFP4、GGUF 与 MLX 等多种版本,目标是在单台 NVIDIA DGX 上运行,同时覆盖 Mac 与本地量化场景。团队公布其在 SWE-bench Verified、Terminal-Bench 2.1 和 CyberGym 等编码与智能体任务上的结果,并采用 MIT 许可证开放。厂商分数仍需要独立复测,但多种量化与部署格式同步上线,说明大型开放模型正在把竞争重点从“能否下载”推进到“能否在一台设备上真正运行”。
来源:Ornith 官方仓库 · HuggingNews 事件汇总
10. SGLang 新插件系统把硬件适配移出主仓库,推理框架开始做“插槽”
标签:SGLang / 推理框架 / 硬件生态
摘要:SGLang 公布新的插件体系,允许硬件厂商和开发者在不修改主仓库的情况下注册自定义平台、KV 缓存、注意力后端、图捕获与编译能力,也能在通用插件中对函数或类注入钩子。插件通过 Python entry points 安装发现,并可用环境变量明确选择,内置平台在没有外部插件激活时继续作为回退。对多芯片生态而言,这类“框架稳定、适配层外置”的结构能降低上游合并成本,但扩散模型支持仍是实验性范围。
11. General Compute 把预填充留给 GPU、把逐 Token 解码交给 Positron
标签:异构算力 / 推理解耦 / AI 芯片
摘要:General Compute 将采购 Positron 的 Atlas 推理系统,并承诺采用下一代 Titan,计划在 2027 年第一季度通过统一端点向客户开放。双方的架构把计算密集的提示词预填充放在 GPU,把更受内存带宽限制的逐 Token 解码交给 Positron 的 memory-first 系统,在同一合同和 SLA 下组合不同芯片。具体部署规模与真实性价比尚待上线后验证,但它提供了一条不同于“所有阶段都堆 GPU”的推理成本路线。
来源:Positron 与 General Compute 官方公告 · General Compute 技术白皮书
12. Voxel 家庭机器人开放 2028 年预约,先卖“会收拾”的明确任务边界
标签:家庭机器人 / 具身智能 / 产品化
摘要:Tuesday Labs 公布 Voxel Series-1 家庭机器人,主打整理房间、寻找物品、取送物品和照料植物四类任务,并以 200 美元可退款费用开放首批编号机型预约,计划 2028 年开始交付。产品采用双 7 自由度手臂、视觉与音频感知,并把“管家性格”作为交互设计的一部分。预约并不等于最终订单,硬件、能力和交付时间仍可能变化;相比泛泛宣称“通用家务”,它至少把第一代产品的可验收任务说得更清楚。
来源:Tuesday Labs 官方产品页 · 官方预约页 · HuggingNews 产品汇总
BEIYOO 判断
DeepInfer 是今天最重要的变化,因为它把讨论从“DeepSeek 又发了一个模型”推到了“这个模型如何被大规模、低成本地服务”。单集群每日 155 万亿 Token 是官方口径,不应直接横向类比其他平台,但公开内核、并行、调度与协议转换,确实让外界第一次更完整地看到 DeepSeek 的生产推理路线。尚未开放的 KV 缓存和负载均衡也同样重要:生产系统的护城河往往恰恰藏在这些不显眼的环节。
Anthropic 和 OpenAI 的动作展示了另一条主线。Claude 不只是回答生物问题,而是在 64 小时里组织设计活动、筛选候选并把结果交给实验室;OpenAI 则通过收购 Orchestra Bio,把模型嵌进药物研发的项目协作。两者都说明 AI for Science 的产品形态正从单点预测工具转向跨模型、数据、实验室和人的长流程系统。
Mastercard 的智能体支付、Mistral 的完整语音管线和 Voxel 的家庭任务边界,又分别补上了交易、交互与物理执行。企业真正要建设的不是一个“万能 AI”,而是一条能清楚回答谁可调用什么、花多少钱、失败后如何回退、结果由谁负责的任务链。
今日深读:为什么推理系统正在成为模型公司的第二张名片
训练决定模型能做什么,推理系统决定这些能力能否以可接受的速度和成本交付。一个多步智能体可能连续调用模型数十次,单次节省几百毫秒、一次缓存命中或一次重试减少,都会被整条链路放大。随着模型分数接近,服务质量越来越取决于调度、并行、缓存和硬件适配。
DeepInfer 的开源让开发者能直接研究 DeepSeek 的工程选择,但不应误读为完整复制其线上服务。官方已经写明,KV 缓存管理与负载均衡仍未完整开放,首版重点也是离线推理。评估时要把“代码可见”“可以运行”和“能稳定支撑生产”分成三个层级。
Google 的 TorchTPU、SGLang 插件和 General Compute 的异构方案则说明,推理层正在主动摆脱单一硬件绑定。对企业最现实的策略不是押注某一块芯片,而是在 API、模型格式、评测集和监控指标上保留迁移能力,让不同硬件在明确任务中竞争。
企业能抄的作业
- 选一条高频任务,将模型、检索、工具、网络和人工修正分别计时,不再只记录模型响应时间。
- 用同一任务集比较两种模型与两种推理后端,至少记录 P50、P95、完成率和单位成功任务成本。
- 逐项标注哪些指标来自厂商、哪些已经内部复测;没有复测的数据不得写进采购承诺。
- 为模型、硬件与服务商预留替换接口,并为超时、额度耗尽和工具失败设置可执行的回退路径。