
News Briefing
今日快讯
今日快讯
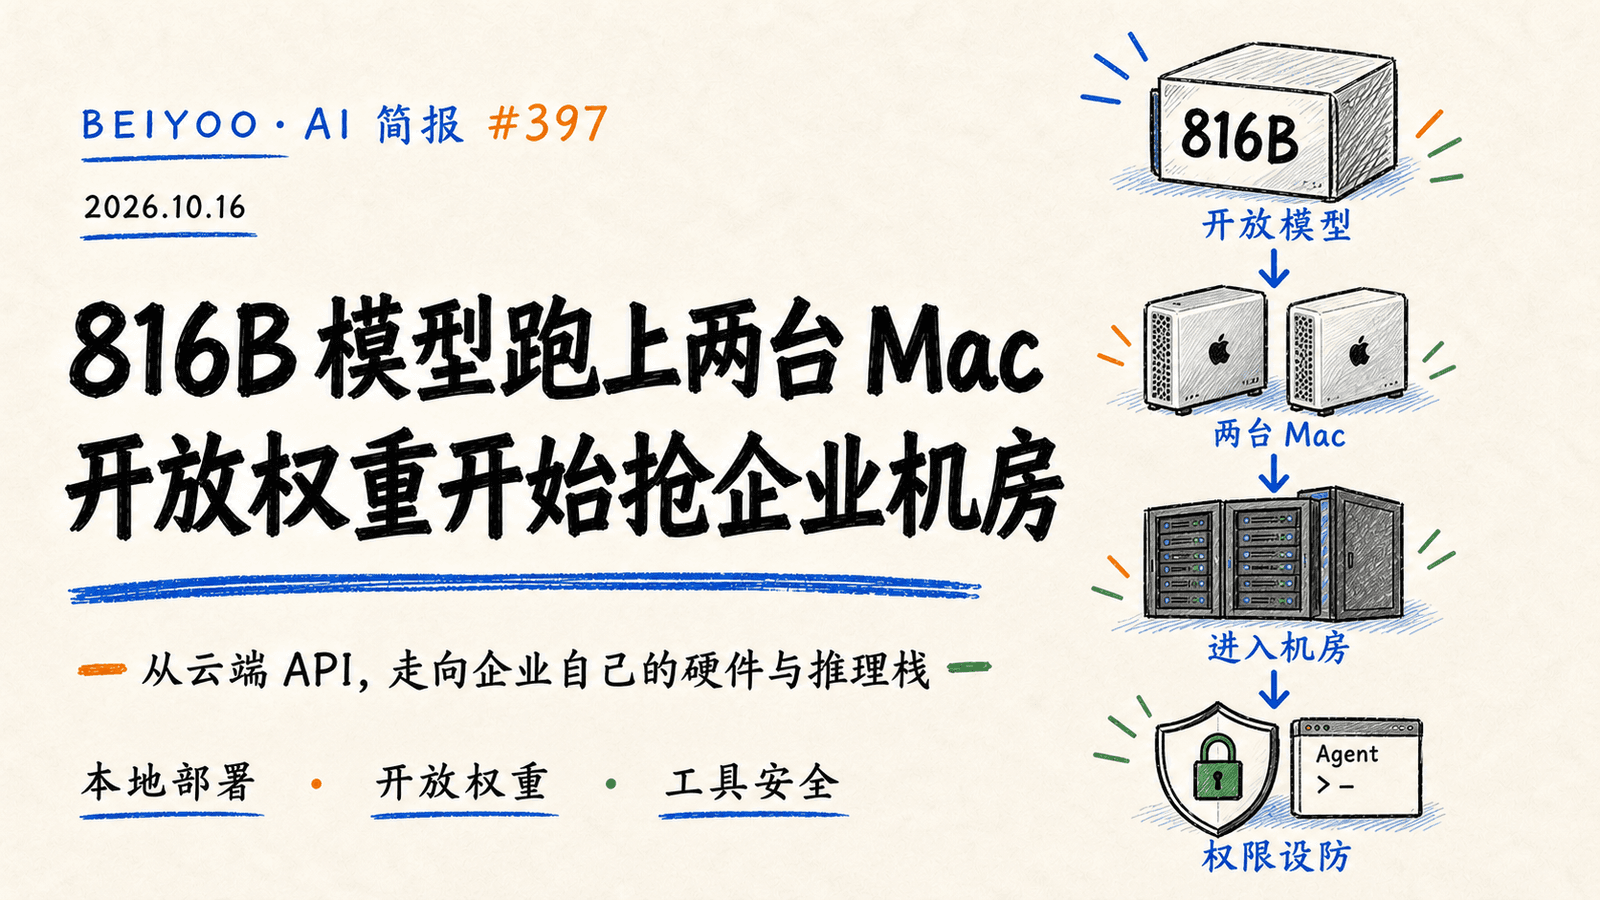
1. Meta 开放 816B 参数 Muse Spark Open,两台 Mac Studio 可运行完整模型
标签:开放权重 / 多模态 / 本地部署
摘要:Meta 发布 Muse Spark Open,模型拥有 816B 总参数、每 token 约 42B 激活参数、100 万 token 上下文,并原生接收文本、图像、视频和音频。官方称其经过 MLX 优化后可在两台 M5 Ultra Mac Studio 上运行,也提供 BF16、NVFP4 权重和多家 API 服务。桌面可运行不等于部署成本低,企业仍需评估完整权重占用、并发吞吐和 Muse Model License 的商业条款。
来源:Meta AI Research 官方发布 · Hugging Face 技术介绍
2. 阶跃星辰开放 Step 5 Preview,600B MoE 面向长周期智能体工作【中国】
标签:国产模型 / 开放权重 / 智能体
摘要:阶跃星辰发布并开放 Step 5 Preview 权重,模型采用 600B 总参数、27B 激活参数的稀疏 MoE 架构,支持最高 100 万 token 上下文与文本、图像输入。官方把仓库级软件工程、金融分析和需要反复调用工具、执行与验证的长周期任务列为重点场景,vLLM 与 SGLang 已提供首日支持。企业在自建部署前应核对 StepFun Community License、硬件拓扑和长上下文 KV Cache 的实际内存需求。
来源:阶跃星辰官方模型卡 · HuggingNews 资讯页
3. 英伟达推出 Nemotron 3.5 Super VL 120B,把视觉与工具调用放进同一模型
标签:多模态智能体 / NVIDIA / 开放模型
摘要:英伟达发布 Nemotron 3.5 Super VL,采用 120B 总参数、12B 激活参数的 MoE 架构,支持 100 万 token 上下文,可直接处理图像、视频、屏幕和文档并调用工具。英伟达同时开放权重、数据与训练配方,并针对 Blackwell 的 NVFP4 推理做了优化。对企业而言,它的价值在于减少文本模型与视觉模型之间反复传递上下文,但厂商基准仍需用真实任务复测。
来源:NVIDIA 技术博客索引 · HuggingNews 资讯页
4. 微软完成 MAI-Base-2 预训练,2.8T 参数模型全部由内部团队打造
标签:基础模型 / Microsoft AI / 模型训练
摘要:Microsoft AI 宣布完成 MAI-Base-2 预训练,官方披露其为 2.8T 总参数、80B 激活参数的 MoE 基础模型,并由 MAI 团队使用内部资源端到端完成。微软称该模型在内部留出评测中超过其测试的开放权重模型,后训练结果将另行发布。当前披露主要是预训练阶段结果,企业不应把基础模型损失指标直接等同于最终产品能力。
来源:Microsoft AI 官方技术文章 · HuggingNews 资讯页
5. FLUX 3 Image Klein 开放 5.6B 权重,单张消费级 GPU 可生成原生 4K 图像
标签:图像模型 / 开放权重 / 创作工具
摘要:Black Forest Labs 发布 FLUX 3 Image Klein,5.6B 图像 Transformer 可在单张消费级 GPU 上运行,支持最高 4K 输出、最多 10 张参考图和基于边界框的布局控制。文本生成、单图编辑和多参考合成由同一个模型完成,并提供蒸馏版与 Base 版。内容团队可获得更可控的本地生成链路,但仍需核对 FLUX Kommunity License、显存占用与商用素材授权。
来源:Black Forest Labs 官方代码库 · 官方 Hugging Face 模型卡
6. Bonsai 2 把 2B 模型压到 0.43GB,端侧智能体继续削减云端依赖
标签:端侧模型 / 低比特量化 / Qwen
摘要:PrismML 发布基于 Qwen 系列的 Bonsai 2 小型模型,2B、4B 和 9B 版本的权重体积分别约为 0.43GB、0.95GB 和 2GB,并面向工具调用与视觉理解。官方演示让敏感数据先在本地处理,只向云端发送少量必要信息,但 86% 云成本降幅来自特定样例,不能直接外推到所有业务。企业应在目标设备上验证速度、精度、发热和混合路由的数据边界。
来源:PrismML 官方公告 · HuggingNews 资讯页
7. Liquid AI 发布 d1-ultra,不生成文字也能给业务决策打概率
标签:决策模型 / 成本控制 / 多模态
摘要:Liquid AI 推出 d1-ultra,模型读取文本和图像后直接为是非题或多选标签返回概率,不生成普通文本 token。官方定价为每百万输入 token 0.042 美元,不收输出 token 费用,目标是商品缺陷、理赔审核与内容分流等结构化决策任务。它适合做低成本筛选器,但企业必须用自己的标注集校准阈值,不能把厂商榜单当作风险审批依据。
来源:Liquid AI 官方发布 · HuggingNews 资讯页
8. DeepSeek 近 5 小时服务中断后补偿 7 天 API 用量【中国】
标签:模型服务 / API 可用性 / 故障恢复
摘要:DeepSeek 确认其 API 与网页服务在北京时间 10 月 15 日 8:11 至 13:04 出现系统故障,影响对话与 V4.1 Flash 等服务,并说明并非模型更新导致。公司将以额度形式返还用户 10 月 8 日至 14 日的全部 API 消耗,同时称已消除相关单点依赖。补偿力度值得注意,但企业更应检查多模型降级、请求重试和关键流程的服务等级约定。
9. Anthropic 让 6 名 METR 研究员获得近似员工级访问,外部评估进入内部系统
标签:AI 安全 / 独立评估 / 模型治理
摘要:Anthropic 已为 6 名 METR 研究员提供公司硬件、办公空间和接近内部风险团队的系统访问,用于独立评估 Claude 风险、事故与安全实践。METR 可以在不经 Anthropic 批准的情况下发布结论;公司只能针对客户数据、法律特权或模型架构等少数类别要求删节,METR 仍可公开评价删节是否合理。这比发布前一次性红队测试更接近持续监督,但评估范围与实际独立性仍需通过后续报告检验。
来源:Anthropic 官方公告 · HuggingNews 资讯页
10. Cognition 推出 Devin Oncall,让智能体直接调查生产告警
标签:AI SRE / 生产运维 / 软件工程
摘要:Cognition 发布 Devin Oncall,产品会接收线上系统告警、调查故障并尝试定位根因,目标是减少工程师在事故中的手工分诊。公司称它已为部分大型客户每天处理数千条告警,但这一规模属于厂商披露,尚需更多独立案例验证。生产环境的 AI SRE 必须限制写权限、保留操作证据,并将高风险修复交给人工批准。
11. OpenRouter 发布 Armor,在智能体调用工具前拦截越权动作
标签:智能体安全 / 工具调用 / 权限控制
摘要:OpenRouter 推出测试版 Armor,用专门的决策模型在智能体执行外部工具前判断调用是否违反策略。产品定位为可接入不同模型和智能体框架的自动权限层,以替代难以覆盖复杂语义的正则规则;其效果目前主要来自 OpenRouter 内部评测。企业可把它作为第二道防线,但确定性权限、金额上限和人工确认仍应由应用代码强制执行。
来源:HuggingNews 产品汇总 · OpenRouter 工具调用安全指南
12. 字节跳动被曝洽购联发科数据中心 AI 芯片,算力供应继续多元化【中国】
标签:AI 芯片 / 数据中心 / 供应链
摘要:报道援引知情人士称,字节跳动正与联发科深入洽谈采购数据中心 AI ASIC,若达成将成为该产品继 Google 之后的第二个大型客户。双方尚未正式确认交易,因此现阶段只能视为供应链方向信号。对大型模型公司而言,多元芯片采购可以降低单一供应商风险,但编译器、算子与推理框架的迁移成本也会随之上升。
BEIYOO 判断
今天不是简单的“大模型又变大了”。Meta、阶跃星辰和英伟达都把开放权重、量化版本和首日推理支持放在发布中心,说明模型厂商开始争夺企业自己的硬件和运行栈。两台 Mac Studio 能跑完整 816B 模型,是桌面工作站进入前沿模型部署讨论的标志,而不是普通电脑已经替代 GPU 集群。
企业获得更多部署选择,也承担更多责任。许可证是否允许商用、长上下文需要多少内存、生产故障如何降级、智能体工具调用怎样阻断,都比单个榜单分数更接近真实成本。开放模型采购的下一阶段,是把模型、硬件、运维与治理放进同一张评分卡。
今日深读:开放权重为什么开始争夺企业机房
过去,开放模型常被理解为可下载但能力落后一代;Muse Spark Open、Step 5 Preview 和 Nemotron 3.5 Super VL 则同时把长上下文、多模态与智能体任务带入开放权重。企业可以在自己的环境里完成推理、微调与审计,不必把全部敏感数据交给外部 API。
但“可以下载”与“可以生产部署”之间还有很长距离。816B 模型即便只激活 42B 参数,完整权重仍要装入内存;100 万 token 上下文还会放大 KV Cache、首 token 延迟和并发压力。厂商给出的两台 Mac 或单张 GPU 配置,更适合成为验证起点,而不是容量承诺。
真正成熟的开放模型策略应该允许任务分层:敏感、低并发任务留在本地,高峰与复杂任务路由到云端,同时保留替换模型的能力。再配合 Armor 这类工具调用拦截、独立安全评估和多供应商降级,企业才能把开放权重变成可控的生产资产。
企业能抄的作业
- 选一个包含长文档、图像和工具调用的真实任务,准备 30 个固定样例与人工标准答案。
- 在云 API、私有 GPU 和桌面工作站上运行同一任务,记录完成率、延迟、吞吐、内存和单任务总成本。
- 在测试环境模拟模型超时、API 中断和越权工具调用,验证降级模型、人工确认与审计记录是否生效。
- 把许可证、模型版本、量化方式和运行硬件写入部署清单,每月复核升级与退出成本。