
News Briefing
今日快讯
阿里发布 Qwen-Image-2.1,70 亿参数图像模型瞄准更低部署门槛
标签:开源模型 / 图像生成
摘要: 当日行业汇总显示,阿里发布 Qwen-Image-2.1,并以 70 亿参数规模强调图像生成能力与可运行性。参数规模不是画质或商用安全的充分条件,但更小的模型确实让本地试用、私有环境验证和成本敏感型项目有了更多选择。团队应在接入前用带有品牌文字、人物、产品细节和边界指令的样本验证,而非只比较展示图。
Qwen3.8-Omni-Flash 把全模态能力与低价 API 一同推入竞争
标签:多模态模型 / API 成本
摘要: 同一轮信息还提到 Qwen3.8-Omni-Flash,以多模态能力和更低 API 定价参与轻量模型竞争。对企业而言,价格下降并不意味着总成本自动下降:图像、音频和视频输入会改变 token、存储、审核和人工复核支出。应将单次调用价格换算成完整任务成本,再决定是否迁移。
Runway 展示实时生成式视频直播,视频 AI 走向逐帧运行
标签:生成式视频 / 实时交互
摘要: 行业汇总显示 Runway 展示了实时 AI 视频直播的方向:生成不再只是提交任务后等待成片,而是随输入持续逐帧变化。实时性会把质量要求扩展到时延、画面稳定、内容安全和人工接管。若用于直播、展厅或客服,团队需要预设中断、审核和降级策略,避免把生成链路直接暴露给公众。
Vals 获 a16z 支持,模型评测成为企业采购的独立环节
标签:模型评测 / 企业采购
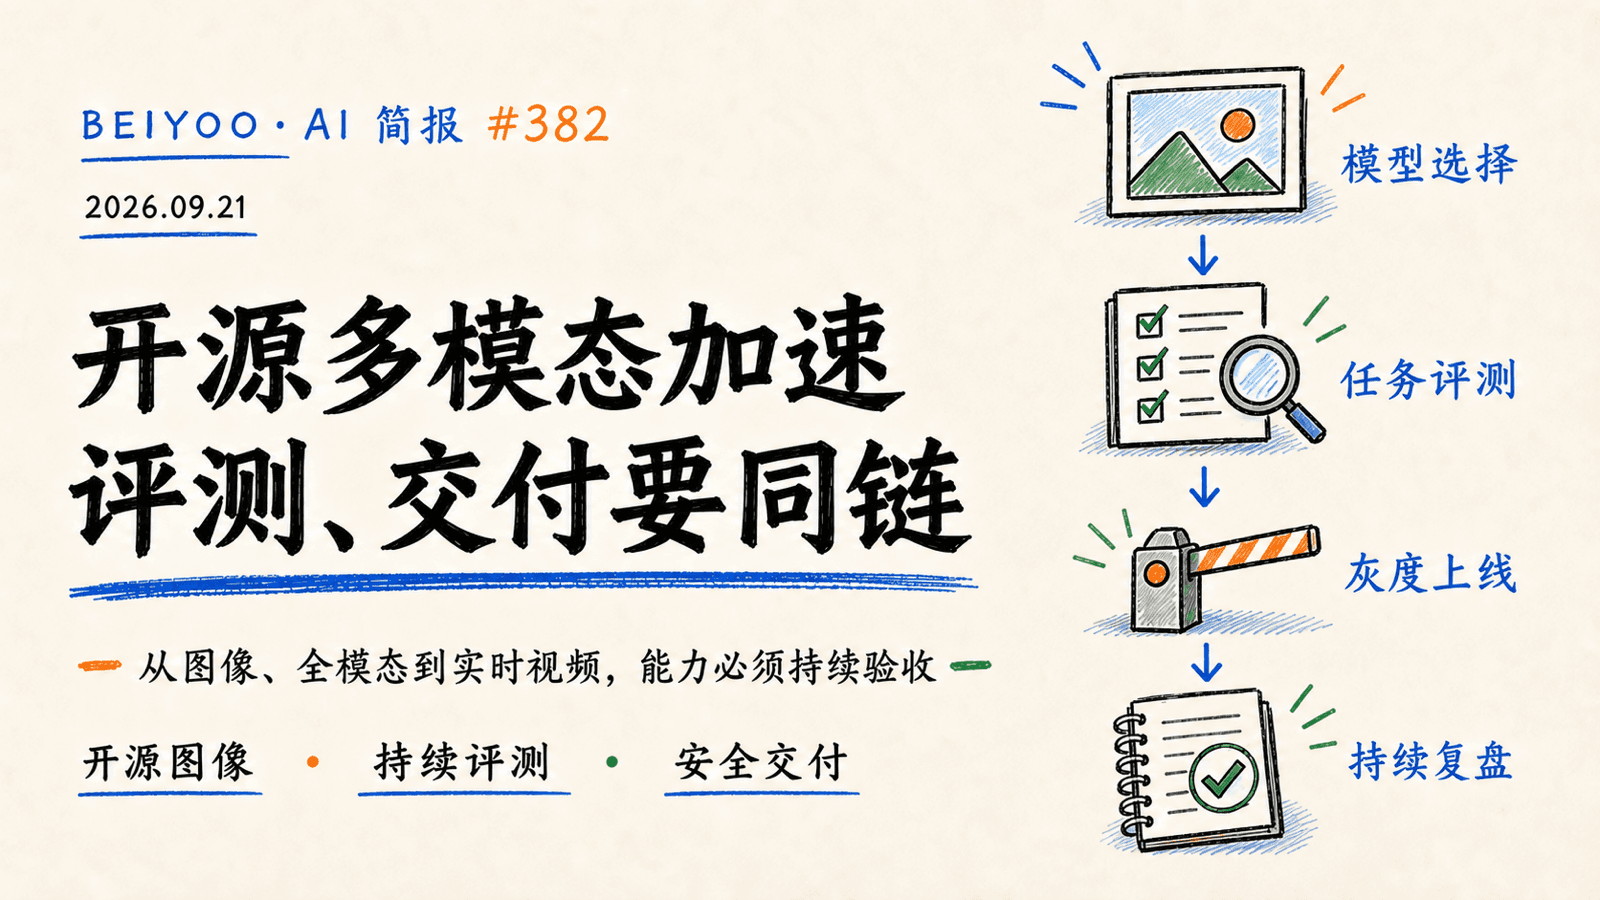
摘要: TechCrunch 报道,获得 Andreessen Horowitz 支持的 Vals 希望成为 AI 评测的标准化平台。模型切换频繁时,企业确实需要一套独立于供应商宣传的测试流程:固定样本、明确通过条件、版本留档和可复现的人工判定。评测不该只发生在采购前,也应覆盖模型、提示词和工具连接更新后的回归测试。
阶跃星辰发布 Step 5 Preview,并预告 10 月开放权重
标签:开源生态 / MoE
摘要: 当日汇总显示,阶跃星辰发布 Step 5 Preview,公布 600B 总参数、27B 激活参数的 MoE 配置,并预告 10 月 15 日开放权重。预览版规格和跑分不能替代正式版本的可用性判断;企业若计划评估,应等权重、许可证和推理栈明确后,再做内部任务复测与兼容性检查。
陶哲轩提前公布 SAIR 开放数学模型计划,主张社区共建训练与评测
标签:AI for Science / 开放科研
摘要: 当日汇总提到,数学家陶哲轩提前公布 SAIR 的开放数学模型计划,方向包括阅读证明、检索文献与形式化协作,并希望由社区参与训练与评测。科研 AI 的价值不只在给出答案,更在于过程能否被领域专家审阅、复现和纠错。企业研发团队也可借鉴这一点,把证据链接、版本与人工确认作为产出的一部分。
硅基流动完成新一轮融资,推理平台竞争仍围绕成本与供给
标签:AI 基础设施 / 推理服务
摘要: 当日汇总显示,硅基流动完成 B+ 二期与 C 轮融资,市场报道估计本轮规模约 8 至 9 亿元。融资数字需要以公司后续公告为准,但信号明确:开发者最终感受到的并非单一芯片性能,而是模型可得性、限流、价格、地域、工具兼容与故障恢复。采购推理服务时应至少保留一条可演练的备选路径。
荣威家越 07 预售,豆包座舱助手进入车端交互入口
标签:端侧智能体 / 智能座舱
摘要: 行业汇总显示,荣威家越 07 在预售中首发豆包座舱助手,包含多音区唤醒和手机 App 远程控制等交互。车端助手的评价不能停在“听懂了没有”:它涉及位置、车辆控制、多人语音和远程动作,必须清晰区分信息问答、建议与实际执行。任何可能改变车辆状态的指令都应设置确认、权限与可追溯日志。
自动驾驶行业讨论统一能力标准,安全评价不能只靠企业自证
标签:自动驾驶 / 安全评测
摘要: TechCrunch 在自动驾驶行业更新中指出,现实道路上尚缺统一的自动驾驶系统能力测试,行业与监管正讨论相应标准。这个问题也适用于各类可行动的 AI:没有明确测试集、通过阈值、持续监测与事故复盘,安全就容易沦为供应商自述。企业应把高风险用例的验收规则在上线前写成可执行条款。
美国日常 AI 使用率加速,采用扩大更需要流程再设计
标签:AI 采用 / 组织变革
摘要: 当日行业汇总提到美国日常 AI 使用率在半年内翻倍的趋势。采用率上升不等于产出同步提升:当更多员工把 AI 用于写作、检索和分析,组织反而更需要统一的数据边界、引用规范和结果复核。最有效的推广通常从一个明确且可衡量的流程开始,而不是一次性给所有人发放同一种工具额度。