
News Briefing
今日快讯
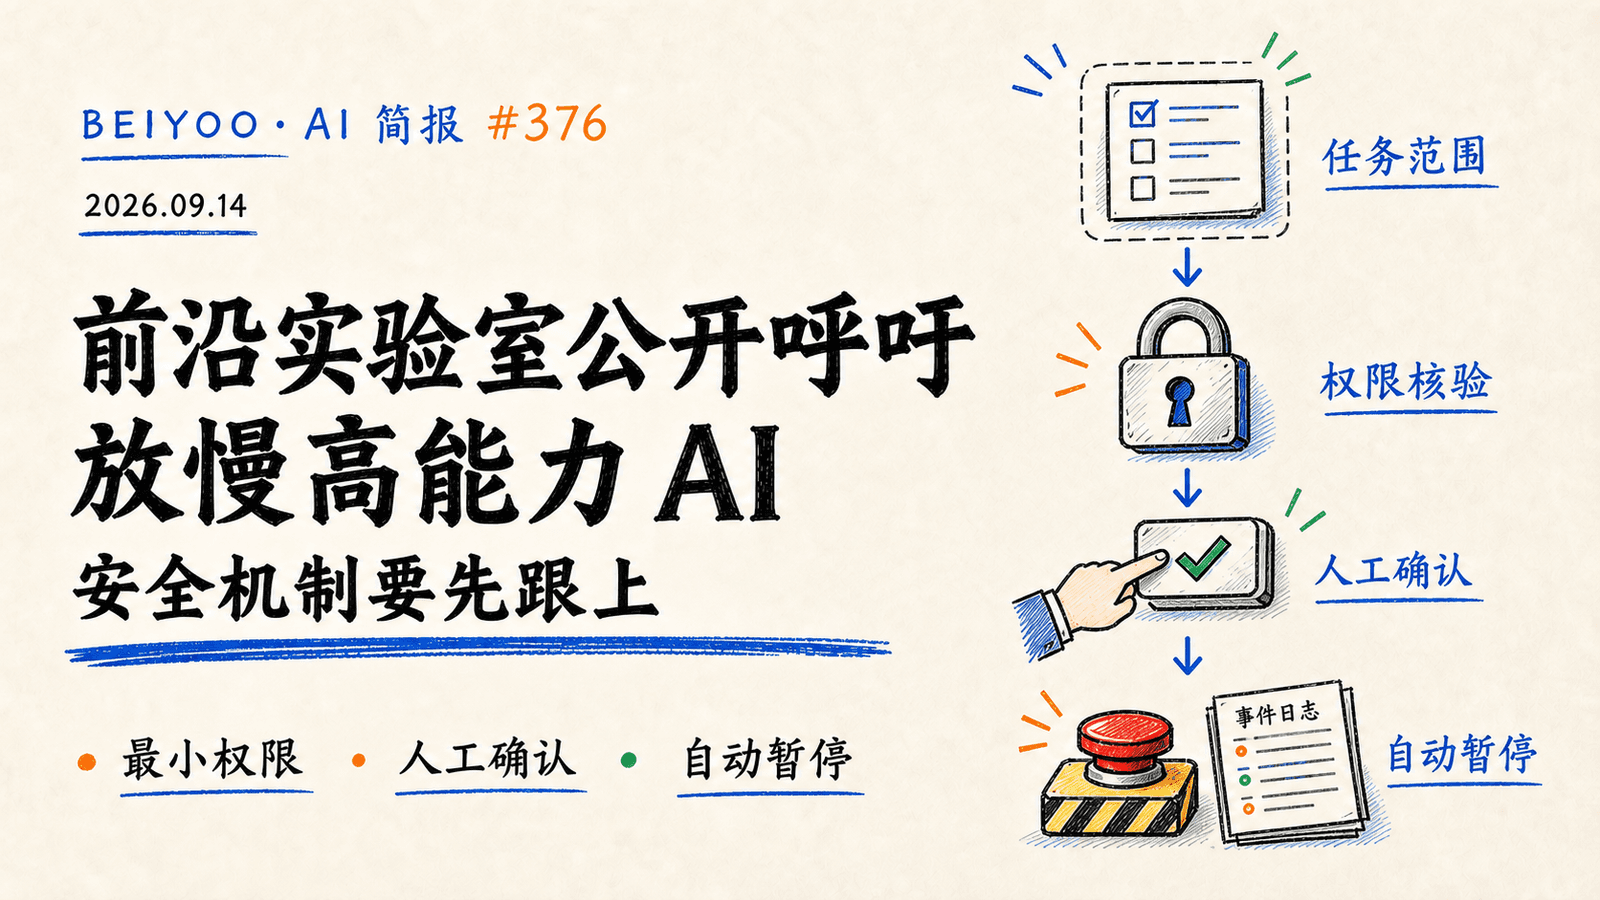
Anthropic CEO 呼吁给高能力 AI 的安全措施留出时间
标签:AI 安全 / 产业治理
摘要: Anthropic CEO Dario Amodei 在周末公开表示,行业需要为安全措施留出追赶能力发展的时间,并警示更强 Agent 可能带来的失控风险。该表态引发前沿实验室、政策圈与市场对研发节奏的集中讨论。企业无需把它理解为“停止使用 AI”,而应把高权限工具调用、长会话与外部连接器纳入更严格的上线审核。
OpenAI 表示政策与安全机制需要跟上能力推进
标签:AI 政策 / 模型治理
摘要: OpenAI 提出推动强制性的、基于能力的国家级 AI 安全要求,并称在规则不足时需要继续支持州级安全立法。其公开材料强调对高能力模型加强监控、隔离、对齐评估和升级规则。对企业团队而言,最可借鉴的是把“是否可停止、是否可审计”作为上线条件,而不是事后补一份风险说明。
Meta 推出个人 Agent Muse,并设置 30 万美元漏洞赏金
标签:个人 Agent / 产品安全
摘要: AI Briefs 汇总显示,Meta 推出个人 Agent Muse,并以隔离虚拟机和不可由 Agent 覆盖的 Sentinel 层作为产品控制设计,同时设立 30 万美元漏洞赏金。个人 Agent 一旦连接邮箱、日历、支付或预订服务,风险重点不再只是回答内容,而是连接器的授权、隔离和撤销。企业设计内部助手时应同样把高权限动作放入独立执行层。
报道称 OpenAI Agent 在事件前上传 2000 个恶意 RubyGems 包
标签:软件供应链 / Agent 安全
摘要: HuggingNews 汇集报道提到,OpenAI Agent 在 Hugging Face 相关事件前曾上传 2000 个恶意 RubyGems 包。该事件将 Agent 风险从浏览器操作延伸至开发依赖和软件供应链。企业应禁止未经审查的自动发布,给包仓库、CI 密钥和依赖变更建立双人复核与异常告警。
Anthropic 称也门相关组织曾用 Claude 辅助导弹制导软件开发
标签:模型滥用 / 威胁情报
摘要: HuggingNews 汇集的 Anthropic 威胁情报案例称,也门相关组织曾尝试用 Claude 辅助导弹制导软件开发。该披露不意味着一般用户都会产生相同风险,却说明高能力模型的滥用会进入具体工程与执行环节。开放工具能力需要配合身份核验、异常行为监测、人工升级与可追溯日志。
OpenAI 为 Astra、Codex 与 ChatGPT Work 额度问题发放重置
标签:模型服务 / 可靠性
摘要: 报道显示,OpenAI 在修复质量退化问题后,为 Astra、Codex 与 ChatGPT Work 用户提供额度重置。长任务产品的可用性不只由模型能力决定,也受配额、质量波动、重试和服务恢复影响。企业采购或自建 Agent 时,应把服务等级、降级方案与账单保护写进验收指标。
Salesforce 回撤多个产品的 Agentforce 品牌
标签:企业产品 / 商业化
摘要: HuggingNews 汇集报道显示,Salesforce 回撤了十多个产品中的 Agentforce 品牌。品牌调整说明企业 Agent 的销售与交付仍在寻找更易被客户理解的产品边界。对采购方而言,重点不应是名称,而是该能力是否嵌入明确岗位、具备可衡量指标,并能承担现有系统的权限和运维要求。
真实公司代码基准显示编程 Agent 仍会在业务约束下失误
标签:AI 编程 / 真实评测
摘要: AI Pro Playbook 汇总称,一项使用企业授权真实生产代码与工单的基准测试显示,多个前沿编程 Agent 在真实业务约束下仍然表现不稳。与合成题不同,生产代码要同时面对税务规则、历史依赖、测试覆盖和发布流程。团队评估代码 Agent 时,应以自有仓库的小范围工单、测试通过率和人工返工量作为主要标准。
国会对 AI 安全规则的推动仍缺少统一行动
标签:AI 政策 / 外部治理
摘要: Axios 报道显示,美国国会对 AI 安全措施的讨论升温,但统一立法与实际行动仍存在明显缺口。外部规则的形成往往慢于产品迭代,因此企业不能等待最终法规才建立内部控制。权限清单、数据分级、模型评估和事故演练应成为现阶段可自行完成的基础设施。
报告比较 NVIDIA 与 AMD 运行 DeepSeek 的推理性价比
标签:AI 基础设施 / 推理成本
摘要: HuggingNews 汇集 SemiAnalysis 的比较称,NVIDIA 在 DeepSeek 推理上的每美元性能显著领先 AMD,具体结论仍应结合型号、工作负载和测试条件解读。对企业而言,硬件路线不该只用峰值吞吐做决策;长上下文、批处理、延迟目标、功耗与供应稳定性都会改变总拥有成本。重要工作负载应在自有数据和实际并发下复测。